해결하려던 문제
게임 콘텐츠가 늘어나면서 수작업 심의의 부담과 판정 일관성이 문제가 되고 있었습니다. 평균 정확도만으로는 모델을 판단하기 어려웠습니다.
- 오류의 비용이 다릅니다. 전체이용가를 청소년이용불가로 판정하는 것처럼 등급 차이가 큰 오분류는 실제 심의에서 훨씬 치명적입니다.
- 위험요소 라벨이 일부에만 있습니다. 라벨이 없는 데이터를 “위험요소 없음”으로 학습하면 모델이 잘못된 정답을 배웁니다.
- 플랫폼별 게임 데이터42만여 건
- 원천 데이터
- 정제·학습셋 구성병합·중복 제거·등급 매핑
- 학습·평가
- 멀티모달 모델텍스트 + 이미지 · 손실 수정
- 추론 서버
- 웹 프로토타입예상 등급·위험점수·근거
- 본인 담당
- 외부 장비·시스템
담당 범위와 협업
직접 한 일
- Steam·IGDB·Google Play 데이터 병합, 중복 제거, 통합 등급 매핑, 이미지·등급 누락 데이터 제외
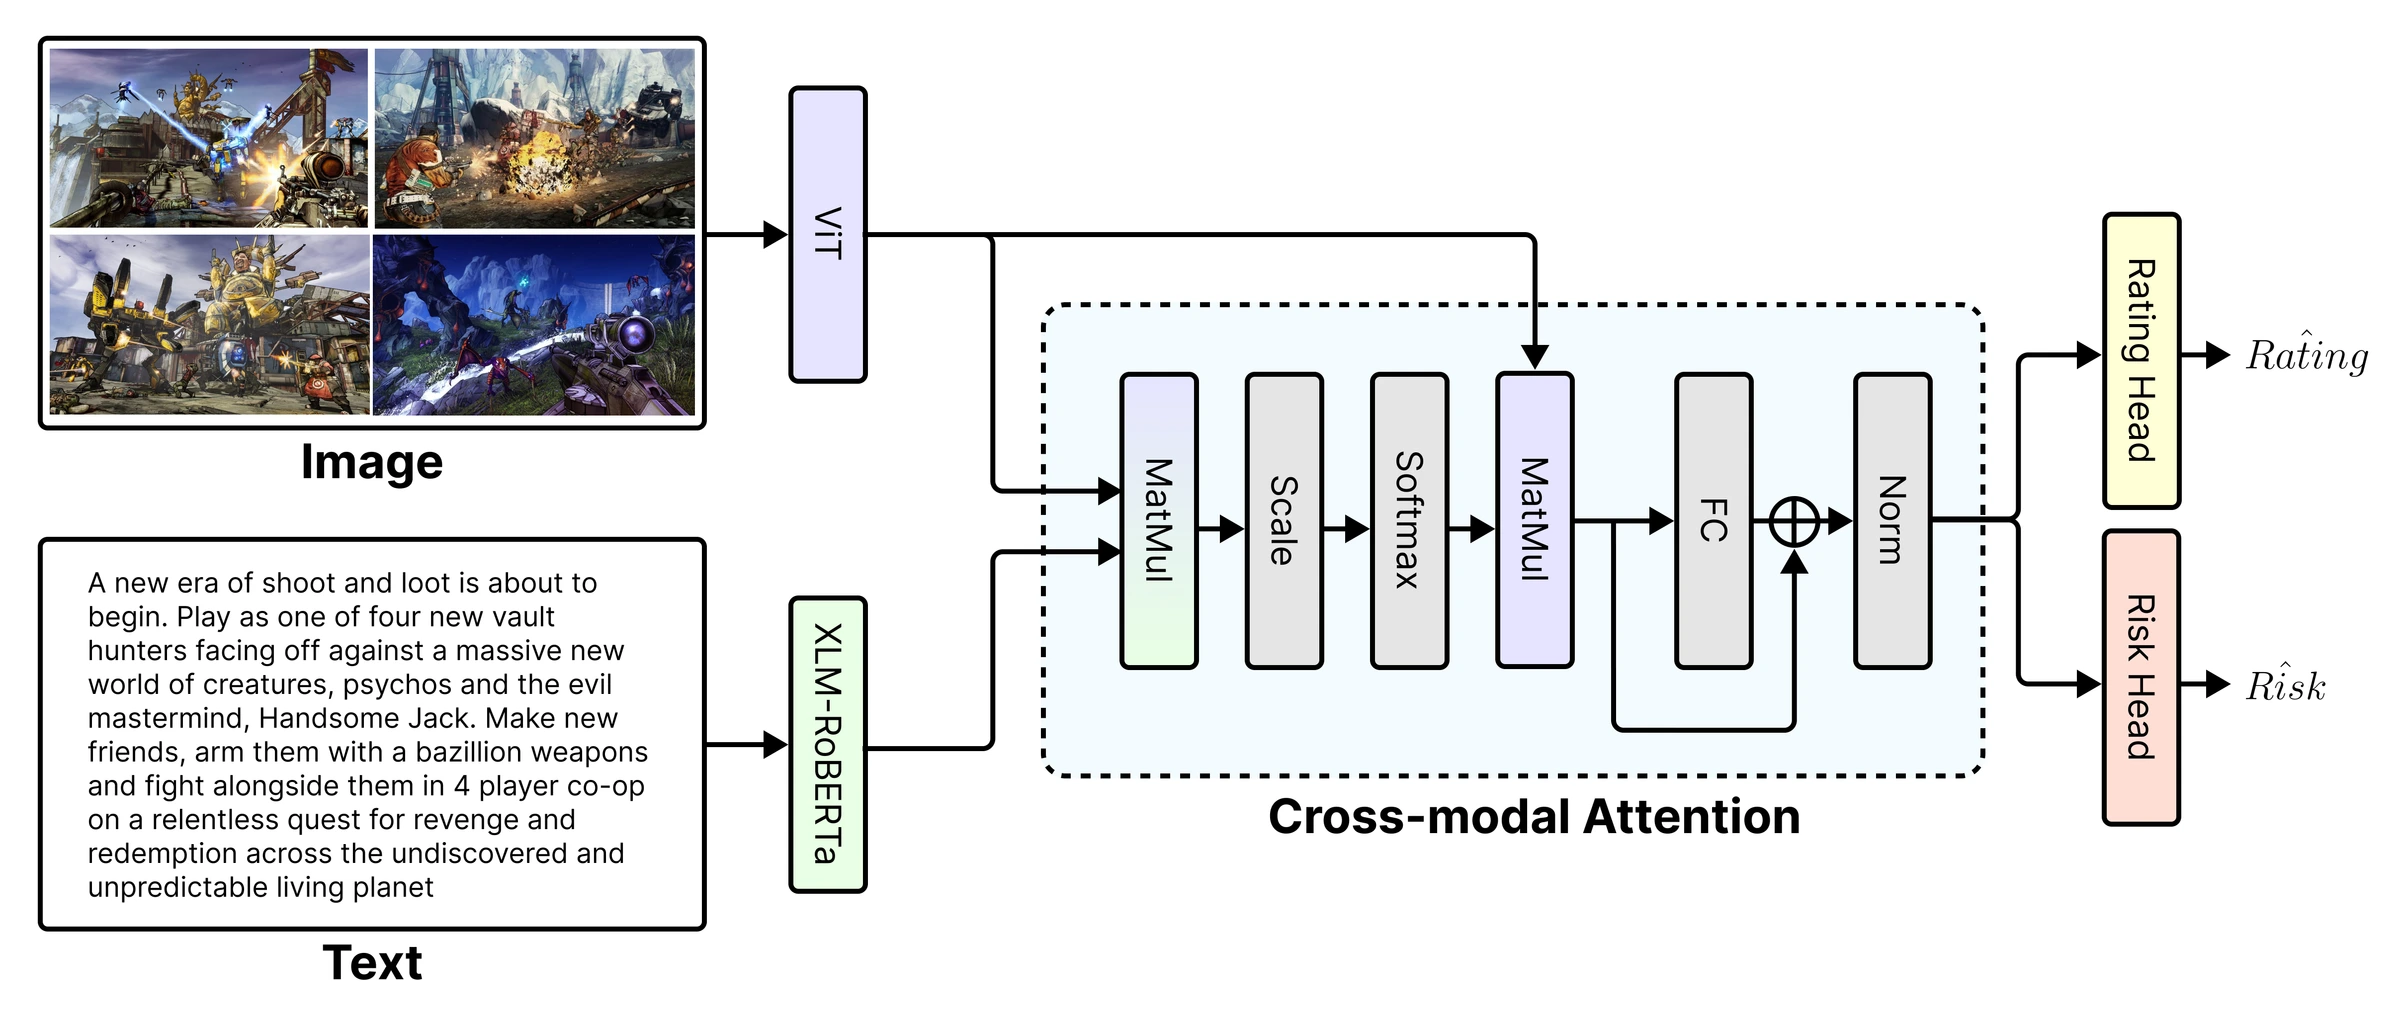
- XLM-RoBERTa 텍스트 특징과 ViT 이미지 특징을 cross-modal attention으로 결합하는 구조 수정
- 4단계 연령등급과 7개 위험요소(폭력·선정·도박·공포·언어·범죄·약물) 동시 예측
- 등급 차이 기반 Distance Penalty, 라벨 보유 데이터만 반영하는 Masked Risk Loss 구현
- 학습·파라미터 조정, 다각도 평가와 실패 원인 분석
- Flask 추론 서버와 웹 화면, 판정 근거 시각화
협업 범위
- 원천 데이터 수집 (산학 협력 기업)
- 모델 아이디어 제안과 검토 (산학 멘토)
- 학습 서버 운영 (서버 담당자)
주요 판단과 선택 이유
- 등급을 크게 틀릴수록 더 큰 벌점을 줬습니다. 등급 차이의 제곱과 클래스 가중치를 반영하는 Distance Penalty를 손실에 넣었고, 평가에서도 이런 대폭 오분류를 따로 보는 지표(CER)를 썼습니다.
- 위험요소 라벨이 없는 데이터는 위험요소 손실에서 뺐습니다. 라벨이 없다고 위험이 없는 것은 아니어서, 라벨이 있는 데이터만 반영하는 Masked Risk Loss를 구현했습니다.
- 결과는 지표 여러 개로 나눠 봤습니다. Accuracy와 함께 Macro·Weighted F1, 혼동행렬, 위험요소별 F1·ROC-AUC를 봐서 강한 부분과 실패한 부분을 나눠 설명했습니다.
- 서버 접근이 제한된 환경에서는 실험 조건을 미리 묶어 전달했습니다. 필요한 실험 조건, 파라미터, 확인 사항을 사전에 정리해 서버 담당자에게 한 번에 전달했습니다.
구현·실험 과정
- 회사가 수집한 게임 420,747건을 플랫폼별로 병합하고, 중복과 이미지·등급 누락 데이터를 제외해 학습셋을 만들었습니다. 학습·검증·테스트는 90:5:5로 나눴습니다.
- 텍스트와 이미지 특징을 결합한 모델에 위 두 손실을 넣어 학습하고 파라미터를 조정했습니다.
- Flask 추론 서버와 HTML·CSS·JavaScript 화면을 만들어, 게임 제목·설명·스크린샷을 넣으면 예상 등급(GRAC·ESRB), 7개 위험점수, 판정 근거가 나오게 했습니다.
청소년 이용불가 판정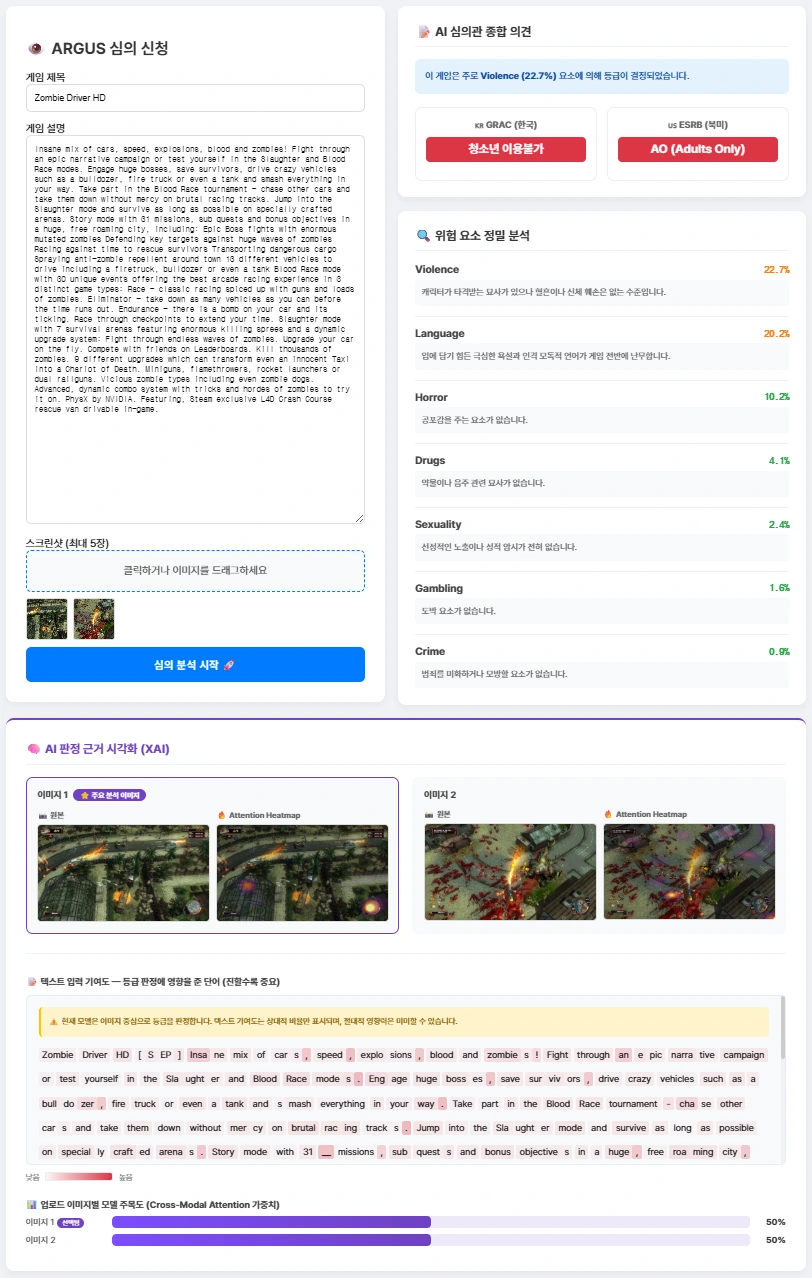
전체 이용가 판정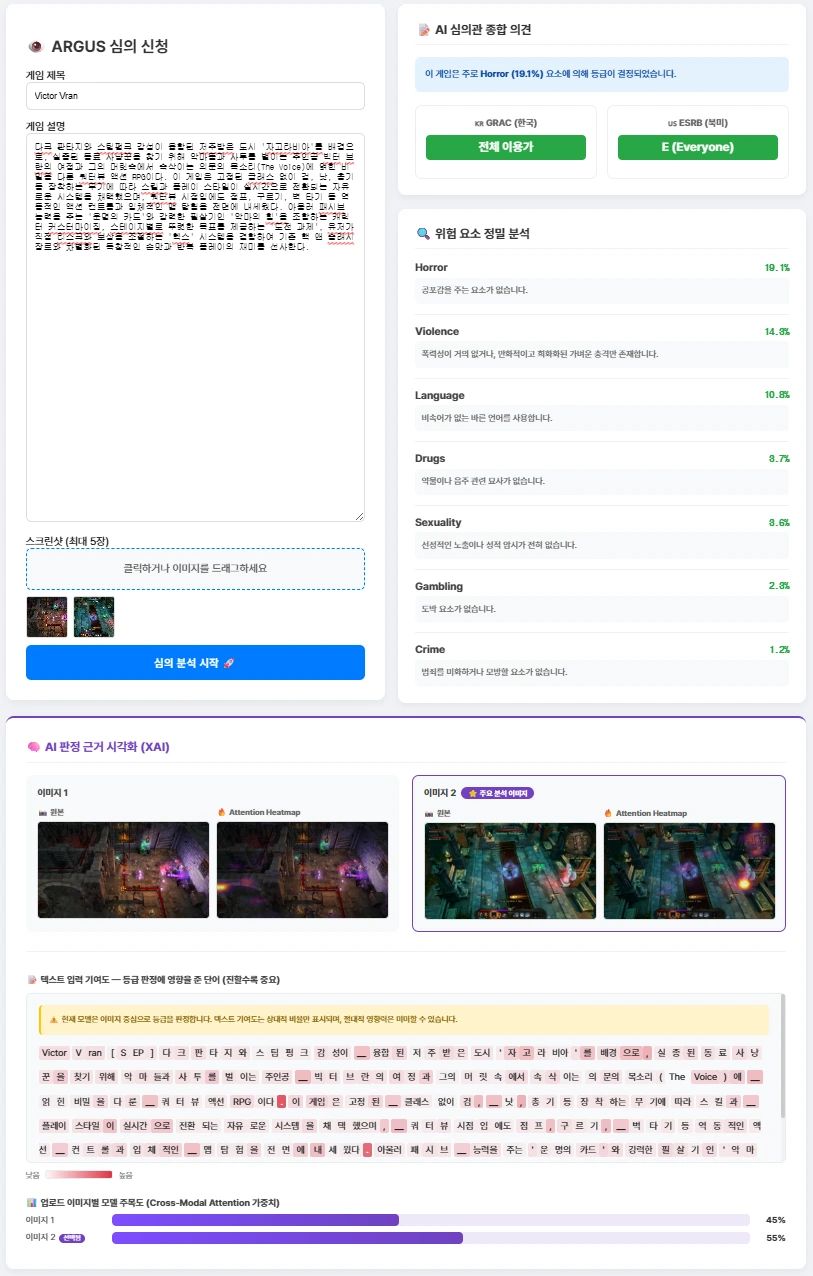
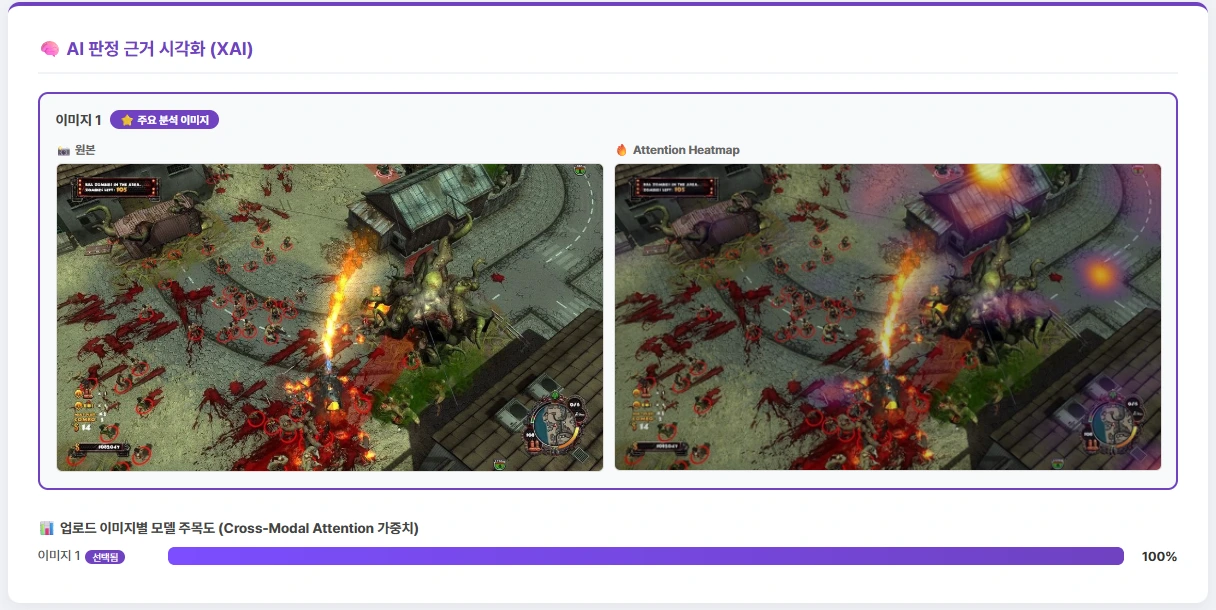
- 중간발표에서 설명 가능성이 부족하다는 피드백을 받아, 이미지 attention heatmap, cross-modal attention 가중치, 텍스트 기여도 시각화를 추가했습니다.
결과와 검증
| 평가 | 값 |
|---|---|
| 테스트 표본 | 21,038건 |
| 연령등급 Accuracy | 67.4% |
| Macro F1 / Weighted F1 | 0.62 / 0.72 |
| 대폭 오분류 비율 (CER) | 31.68% |
| 위험요소 F1 (라벨 보유 테스트 2,084건) | 폭력 91.0%, 언어 89.4%, 도박·범죄·약물 0 |
출처: 최종발표·보고서 평가표. CER은 개선 폭이 아니라 최종 모델의 오류를 측정한 값입니다.
- 위험요소별로 나눠 평가해, 평균 정확도에 가려져 있던 실패를 찾았습니다. 도박·범죄·약물은 양성 데이터가 부족해 F1이 0이었고, 원인을 데이터 불균형으로 분석해 보고서에 정리했습니다.