해결하려던 문제
- 데이터: 의료진이 검증한 이상행동 구간 라벨과 원본 영상의 시간이 일부 맞지 않았습니다. 그대로 자르면 실제와 다른 구간이 학습·평가 데이터에 섞입니다.
- 실시간 처리: 감지 결과를 기존 병원 관제시스템으로 보내야 했지만, 네트워크 요청이 영상 추론을 멈추게 해서는 안 됐습니다. 프레임마다 알림이 나가는 것도 막아야 했습니다.
- 네트워크: 병원 보안망에서는 전송이 실패했을 때 프로그램 문제인지 방화벽·보안 설정 문제인지 바로 구분하기 어려웠습니다.
시스템 구성
- 병동 CCTV 영상
- 프레임
- 이상행동 추론 모델DINOv3 특징 + HAT 기반 모델
- 프레임별 판정
- 이벤트 판정·전송C++ EventProcessor · 본인 구현
- REST · JSON (별도 스레드)
- 병원 관제시스템기존 시스템
- 본인 담당
- 협업자·팀원 담당
- 외부 장비·시스템
이상행동 인식 모델
과제 초기(2022~2023)에는 사람 검출 → 관절 위치 추정 → 규칙 기반 판단으로 행동을 인식했습니다.
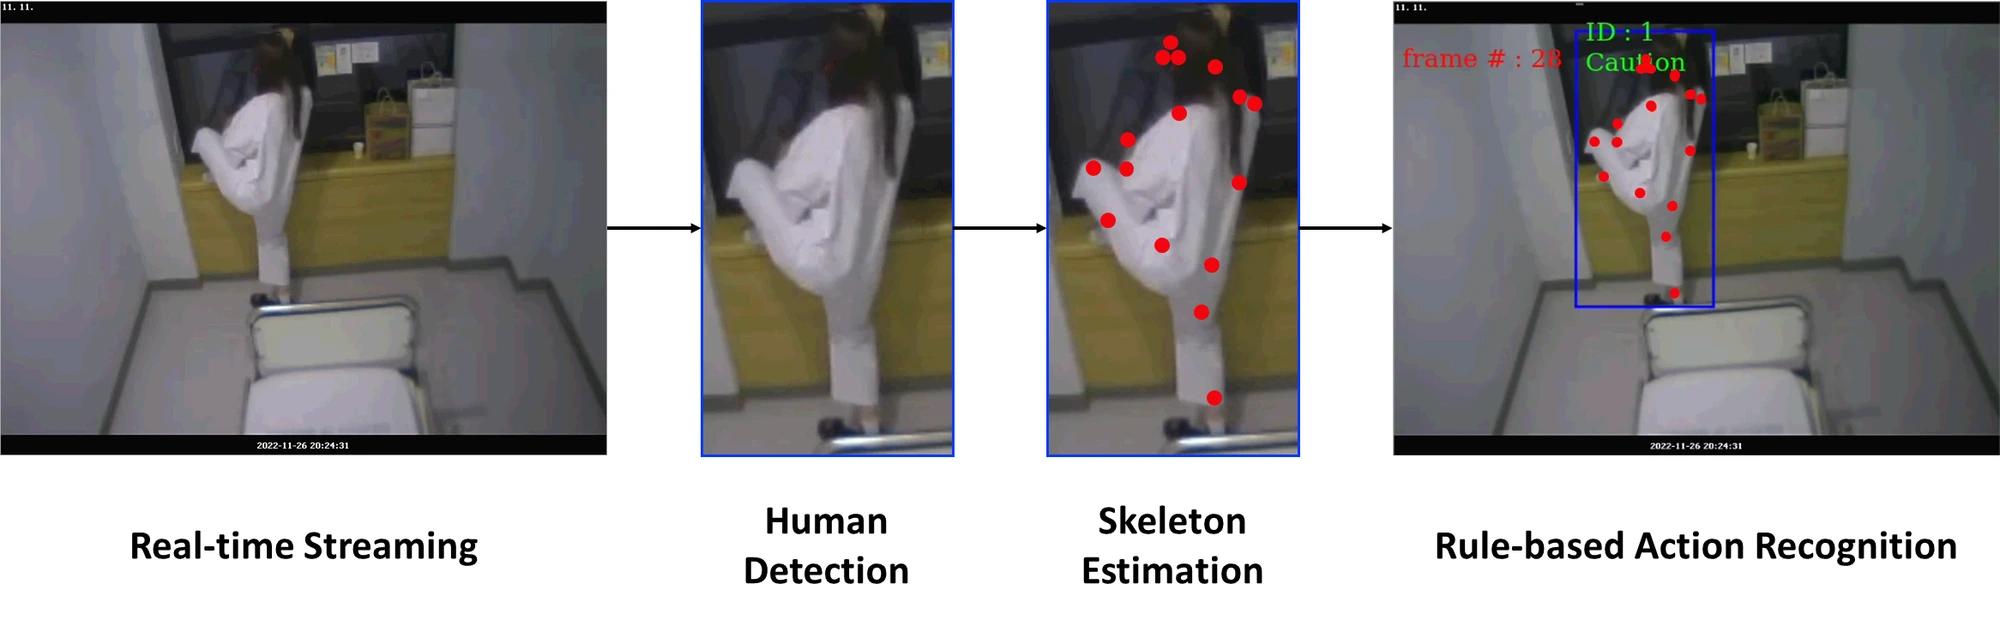
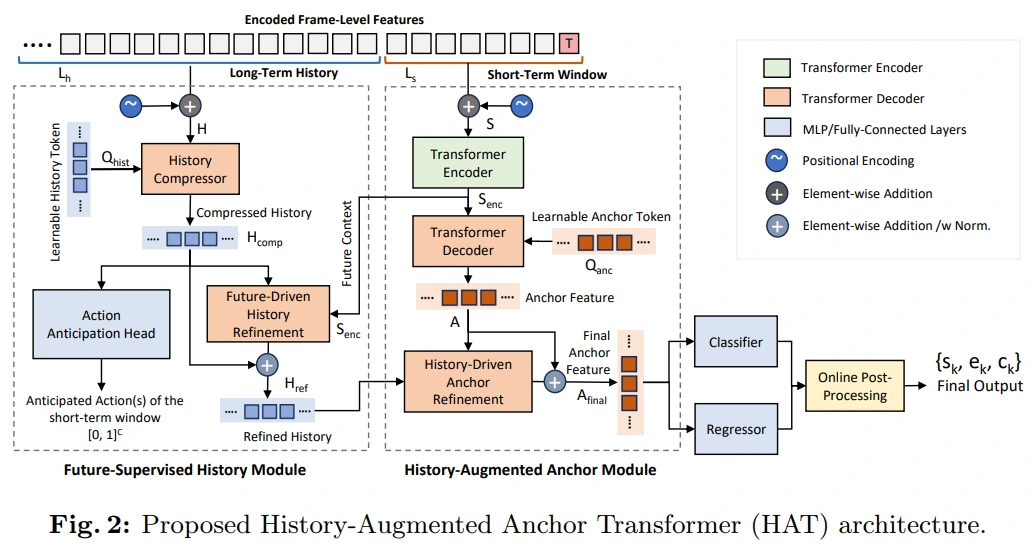
본인이 참여한 단계(2025)에서는 구조가 바뀌었습니다. 프레임 전체를 DINOv3로 768차원 특징 벡터로 바꾸고, 실시간 행동 구간 검출 모델인 HAT를 바탕으로 박사과정 연구원이 수정한 모델이 프레임마다 abnormal·harm·selfharm·background 4개 중 하나로 판정합니다. 본인은 HAT 실험 환경을 꾸려 파라미터 변경 실험과 비교실험을 맡았고, 모델이 낸 판정을 관제 알림으로 바꾸는 부분을 C++ 추론 프로그램에 붙였습니다.
담당 범위와 협업
직접 한 일
- 라벨 구간과 원본 영상 타임스탬프 대조, 불일치 보고, 수정 라벨 기준 재처리 (Python)
- ECCV24-HAT 실험 환경 구성, 수정 모델의 파라미터 변경 실험과 논문용 비교실험
- C++ 이벤트 판정·REST 전송: 판정 창, 반복 알림 대기, 별도 스레드 전송, 요청·응답 로그
- 현장 방문 전 네트워크 점검 준비, 병원 전산팀과 보안망 문제 대응
다른 담당자
- 이상행동 인식 모델 수정·설계 (박사과정 연구원 2명)
- 이상행동 구간 라벨 검증 (병원 의료진)
- 관제시스템 수신부와 병원 보안망 설정 (병원 측)
주요 판단과 선택 이유
- 잘라 낸 결과는 원본 영상 타임스탬프와 직접 대조했습니다. 코드가 오류 없이 끝났다고 데이터가 맞는 것은 아니었습니다.
- 라벨 수정은 의료진에게 맡겼습니다. 라벨은 의료진이 검증한 기준이므로, 불일치를 보고하고 수정된 라벨 문서를 받아 같은 기준으로 다시 처리했습니다.
- 알림 여부는 일정 시간 동안의 판정 비율로 정했습니다. 프레임마다 알림을 보내면 같은 상황에서 알림이 쏟아지고, 표본이 1~2개뿐일 때는 오판하기 쉽습니다.
- 전송은 영상 처리와 다른 스레드에서 했습니다. 관제 서버가 느리거나 응답하지 않아도 추론 루프는 멈추지 않습니다.
- 요청과 응답을 모두 로그로 남겼습니다. 병원 보안망에서는 실패 원인이 프로그램인지 방화벽·보안 설정인지 바로 알기 어려워, 판단 근거를 남겨 두려 했습니다.
구현 과정
1. 처리 결과를 원본 시간축과 직접 대조
잘라 낸 결과를 원본 영상 타임스탬프와 비교해 불일치를 찾았고, 의료진에게 보고해 수정된 라벨 문서를 받은 뒤 같은 기준으로 다시 처리했습니다.
- 1의료진 검증 라벨이상행동 구간
- 2Python 영상 분할
- 3원본 타임스탬프와 대조불일치 발견
- 4불일치 보고임의 수정하지 않음
- 5수정 라벨 수령
- 6같은 기준으로 재처리
2. 실시간 처리와 외부 통신 분리
최근 일정 시간의 판정을 모아 비율로 판단하고, 전송은 별도 스레드에서 처리합니다.
| 설정 | 값 | 이유 |
|---|---|---|
| 판정 창 | 5초 | 최근 프레임 판정을 모아 이상행동 비율을 계산 |
| 알림 기준 비율 | 50% | 창 안에서 background가 아닌 프레임이 절반 이상일 때만 알림 |
| 최소 판단 시간 | 2초 | 표본이 1~2개뿐일 때 바로 알림이 나가는 오판 방지 |
| 알림 대기 (cooldown) | 60초 | 같은 상황에서 알림이 반복 전송되는 것을 제한 |
| 연결 제한 시간 | 5초 | 관제 서버가 응답하지 않을 때 전송 스레드가 무한히 기다리지 않도록 |
실제 코드에서 핵심만 추렸습니다.
// 프레임마다 호출: 판정을 5초 창에 넣고, 창 밖으로 밀려난 판정은 버린다
void EventProcessor::OnNewFrame(int64_t labelId) {
  std::lock_guard<std::mutex> lock(mtx_);
  auto now = std::chrono::steady_clock::now();
  frameWindow_.push({ now, labelId });
  while (!frameWindow_.empty() && frameWindow_.front().first < now - kWindowDuration)
    frameWindow_.pop();
  CheckForAlert();
}

void EventProcessor::CheckForAlert() {
  auto now = std::chrono::steady_clock::now();
  if (now - lastAlertTime_ < kCooldownDuration) return;          // 60초 안에는 다시 보내지 않음
  auto span = frameWindow_.back().first - frameWindow_.front().first;
  if (span < kMinWindowDurationForAlert) return;                 // 2초 이상 쌓인 뒤에만 판단

  int alertFrameCount = 0;
  std::map<int64_t, int> eventCounts;
  for (auto q = frameWindow_; !q.empty(); q.pop()) {
    int64_t label = q.front().second;
    if (label != 3) { alertFrameCount++; eventCounts[label]++; } // 3 = background
  }
  if (alertFrameCount == 0) return;

  double proportion = static_cast<double>(alertFrameCount) / frameWindow_.size();
  if (proportion >= alertThreshold_) {                           // 50% 이상이면
    SendRestApiAlert(mostFrequent(eventCounts));                 // 가장 많이 나온 이상행동 하나만 전송
    lastAlertTime_ = now;
    clearWindow();
  }
}

void EventProcessor::SendRestApiAlert(int64_t eventId) {
  std::thread([=]() {                                       // 영상 처리 스레드를 막지 않음
    httplib::Client cli(host, port);
    cli.set_connection_timeout(5, 0);
    log("[API] Send alert. (Request: " + body + ")");
    auto res = cli.Post(path, body, "application/json");
    log(res && res->status == 200 ? "[API] Data sent successfully ..."
                                  : "[API-ERROR] ...");     // 실패 원인을 로그로 남김
  }).detach();
}
요청과 응답은 콘솔과 별도 API 로그 파일에 함께 기록해, 전송 실패 시 어느 단계에서 멈췄는지 확인할 수 있게 했습니다.
[API] Send alert. (Request: {"Code":"<장비 코드>","Date":"2025-11-12","Info":"abnormal","Time":"21:41:48"})
[API] Data sent successfully (Response: "Y/전송완료")
[API] Send alert. (Request: {"Code":"<장비 코드>","Date":"2025-11-12","Info":"abnormal","Time":"21:42:48"})
[API] Data sent successfully (Response: "Y/전송완료")
같은 상황에서 알림이 60초 간격으로만 전송되는 것을 로그로 확인할 수 있습니다.
3. 현장에서 프로그램과 보안망 문제를 나눠 대응
현장 방문 전에 Linux curl 등으로 관제 서버 연결을 확인하는 방법을 준비했습니다. 병원에서는 애플리케이션 문제와 방화벽·보안 설정 문제를 분리한 뒤 전산팀과 함께 대응했습니다. 라이다 현장에서 익힌 구간별 점검 방식을 그대로 썼습니다.
결과와 검증
- 재처리한 데이터로 모델 실험과 비교실험을 진행했습니다.
- 의료진과 배우가 참여한 현장 검증에서 이상행동 감지와 관제시스템 이벤트 전달을 확인했습니다.
- 전송 결과가 요청·응답 로그로 남아, 실패 시 프로그램·네트워크 중 어느 쪽 문제인지 확인할 근거가 생겼습니다.